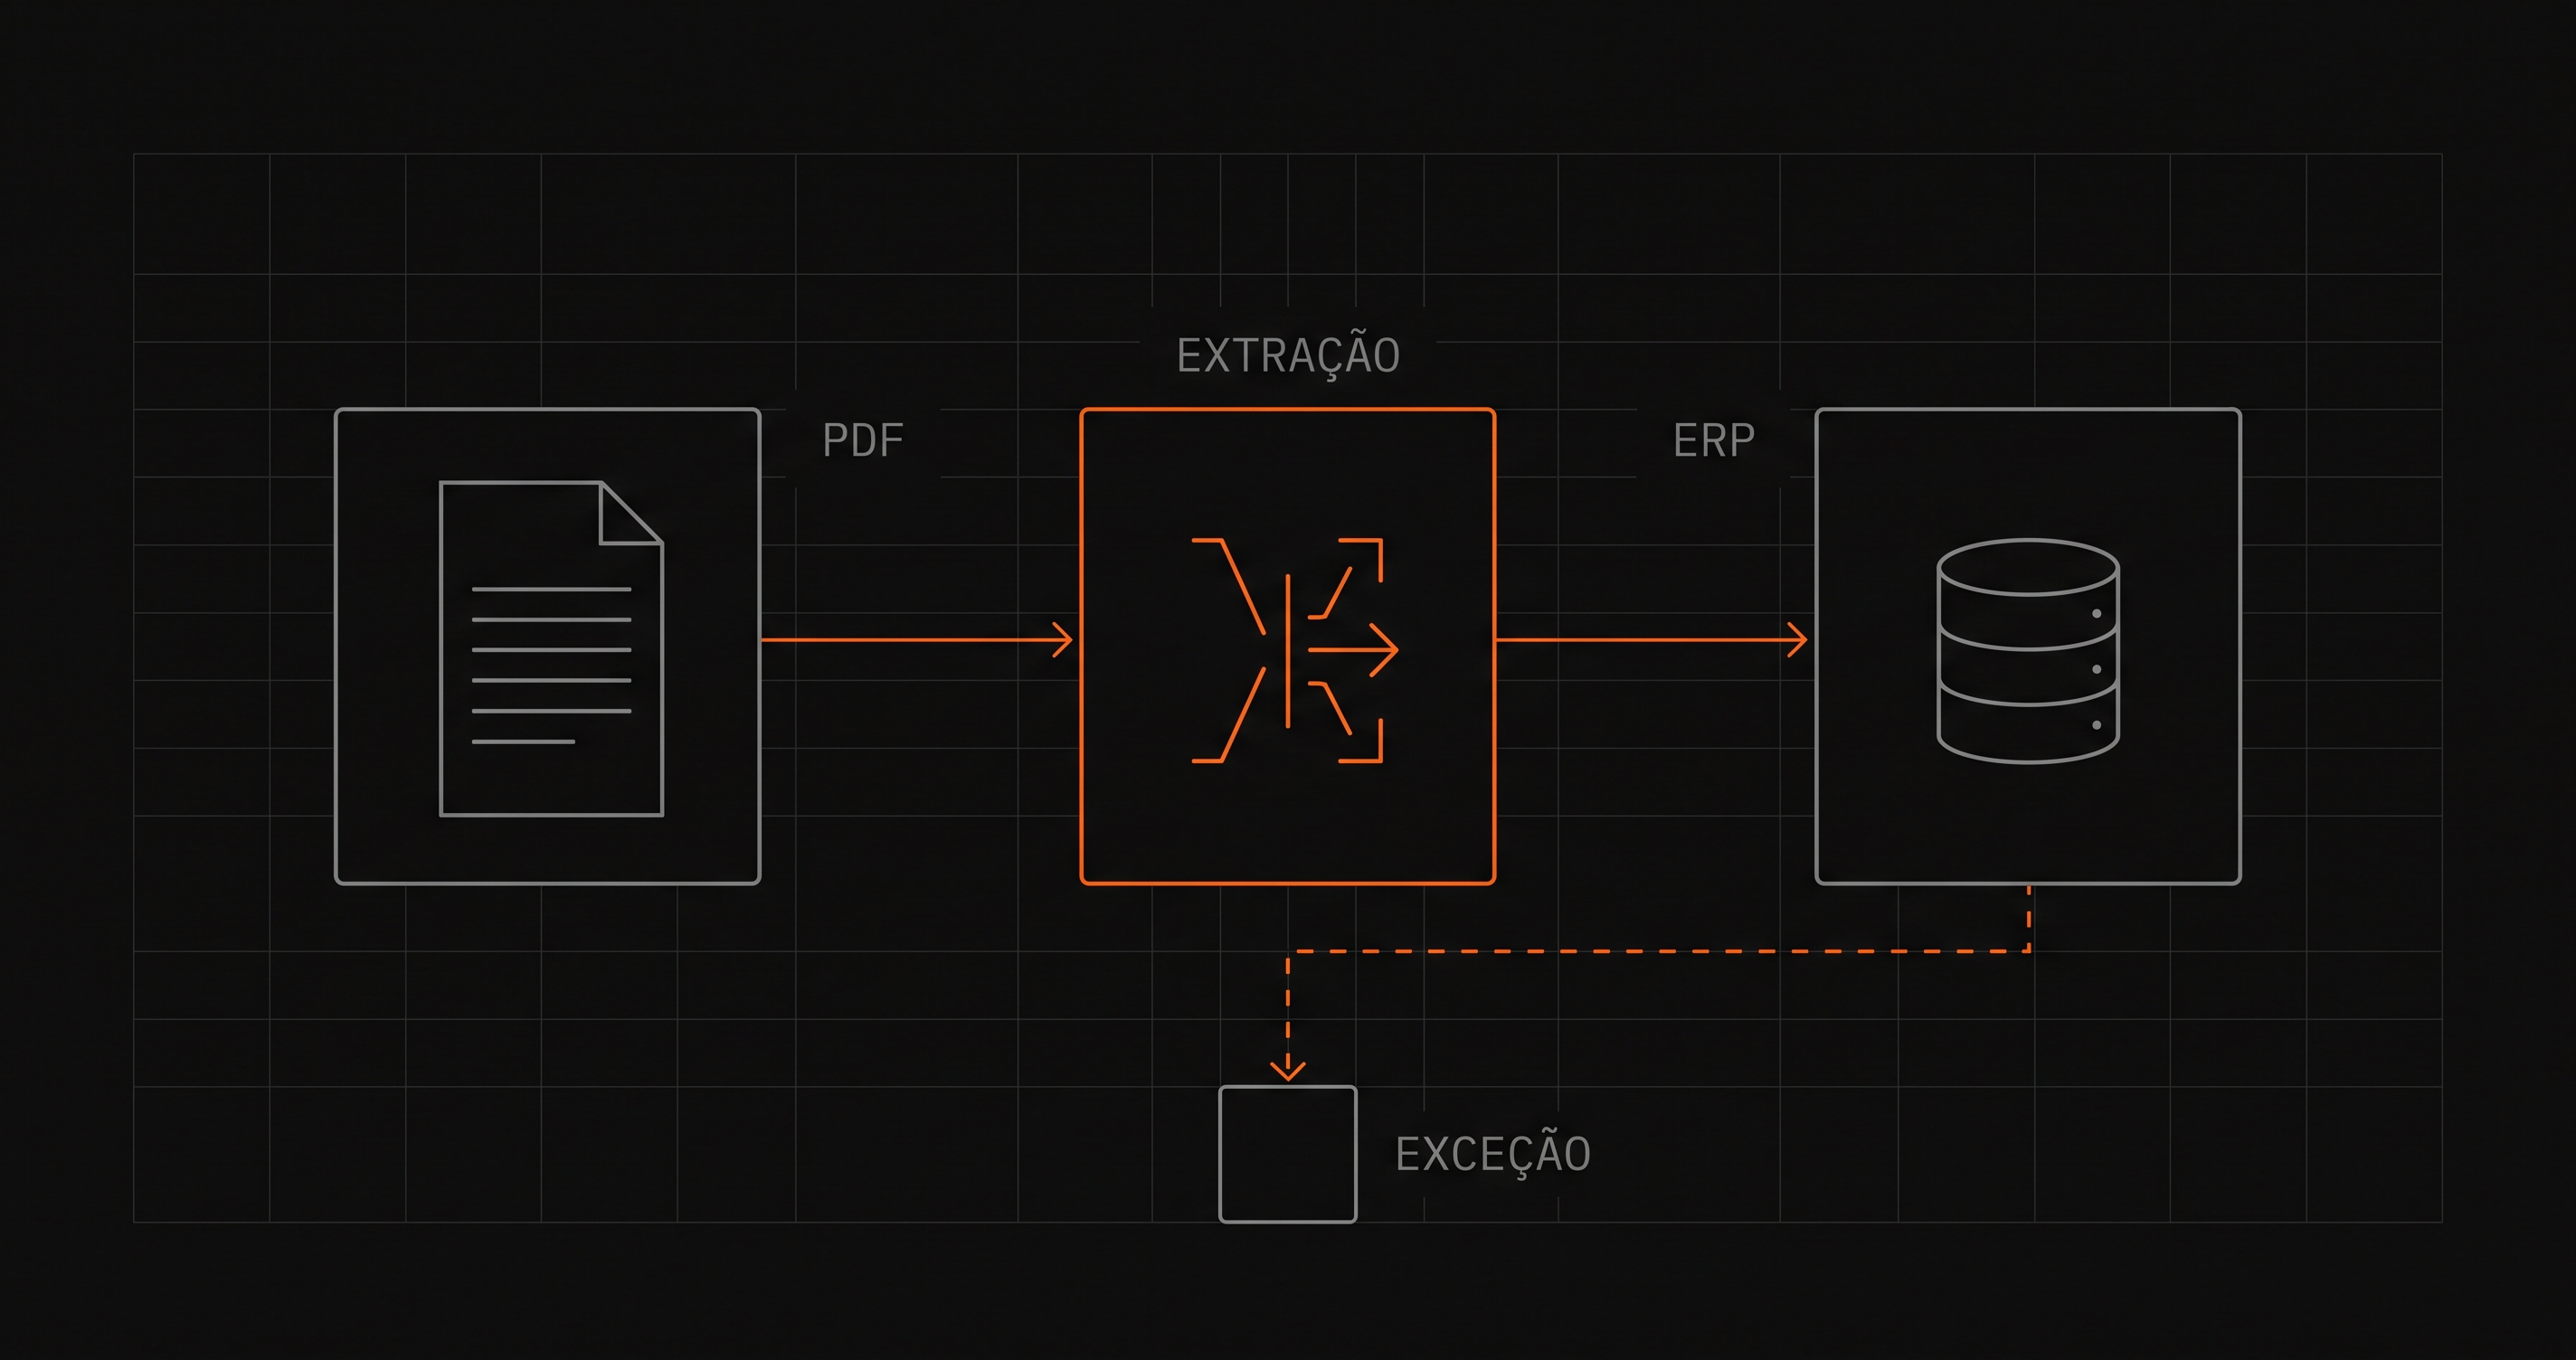
Modelos de linguagem já leem faturas de serviço, notas de prefeitura, contratos e extratos em PDF com qualidade suficiente para produção — o que muda em relação ao OCR tradicional é que não existe mais template por fornecedor. O que separa um piloto bonito de um processo confiável não é o modelo: é exigir saída estruturada e validar cada campo extraído contra uma fonte independente. Sem essa camada de validação, você trocou digitação por conferência.
O problema que a NF-e não resolveu
A nota fiscal eletrônica de mercadoria virou XML há mais de uma década. O ERP consome, concilia, escritura. Resolvido.
O resto do financeiro não teve a mesma sorte. Continuam chegando em PDF, e-mail ou digitalização:
- Notas fiscais de serviço, cada prefeitura com seu layout — e o XML da NFS-e, quando existe, nem sempre chega ao fornecedor de forma padronizada.
- Faturas de energia, telecom, água e locação.
- Contratos de aluguel, prestação de serviço, dívida e seguro.
- Extratos e relatórios de adquirentes fora do padrão CNAB.
- Relatórios de comissão de representantes, cada um em uma planilha diferente.
- Apólices, endossos e avisos de sinistro.
O tratamento disso é sempre o mesmo: alguém abre o arquivo, lê, digita em outro sistema. Suponha um financeiro que recebe 400 documentos desse tipo por mês, a três minutos cada — número ilustrativo. São 20 horas mensais de trabalho que não produz nenhuma informação nova; apenas transporta dado de um lugar para outro.
Por que as tentativas anteriores falharam
Automatizar leitura de documento não é ideia nova. As duas abordagens anteriores esbarraram no mesmo obstáculo.
OCR puro
Converte imagem em texto e para por aí. Você recebe um bloco de caracteres sem saber qual número é o valor líquido e qual é a base de ISS. Serve como etapa, não como solução.
Template por fornecedor
Funciona: você marca em que região do documento fica cada campo e extrai por coordenada. O problema é manutenção. Cada fornecedor novo exige um template novo, e qualquer mudança de layout quebra o que já estava rodando. Em uma base com centenas de fornecedores, o esforço de manter os templates supera o de digitar.
O modelo de linguagem muda essa equação porque interpreta o documento em vez de mapeá-lo. Ele identifica o valor líquido porque entende o que "valor líquido" significa naquele contexto — mesmo que apareça em uma posição inédita, com outro nome, em um documento de um município que você nunca viu.
Como o fluxo funciona na prática
1. Captura
O documento precisa chegar sozinho. As três origens mais comuns são uma caixa de e-mail dedicada, uma pasta monitorada em nuvem ou um portal de fornecedor. Se alguém precisa arrastar o arquivo manualmente para começar o processo, metade do ganho já foi embora.
2. Preparação
PDF gerado por sistema já tem camada de texto e vai direto para o modelo. Documento digitalizado ou fotografado passa antes por OCR. Aqui vale a inversão: o OCR deixou de ser a solução e virou pré-processamento — e só quando necessário.
3. Extração com saída estruturada
Este é o ponto crítico. Peça ao modelo um objeto com campos definidos, não um texto explicativo. Algo como:
{
  "cnpj_prestador": "00.000.000/0001-00",
  "numero_documento": "12345",
  "competencia": "2026-07",
  "valor_bruto": 12500.00,
  "retencoes": {"iss": 625.00, "irrf": 187.50, "inss": 0.00},
  "valor_liquido": 11687.50,
  "vencimento": "2026-08-15",
  "confianca": "alta",
  "campos_nao_encontrados": []
}
Dois campos ali não vêm do documento e são os mais úteis: a autoavaliação de confiança e a lista do que o modelo não conseguiu localizar. Um modelo que declara "não encontrei o vencimento" é infinitamente melhor que um que inventa uma data plausível. Peça isso explicitamente no prompt.
4. Validação determinística
Nenhum campo extraído entra no sistema sem passar por regra fixa. As checagens que resolvem a maior parte dos casos:
- Aritmética interna: bruto menos retenções tem que fechar com o líquido. Se não fecha, o documento vai para conferência.
- Cadastro: o CNPJ extraído existe na base de fornecedores? O nome bate?
- Fonte independente: o valor e o vencimento conferem com a linha digitável do boleto anexo, que é estruturada e confiável.
- Limites de sanidade: valor muito acima da média histórica daquele fornecedor, competência futura, vencimento retroativo.
- Duplicidade: mesmo fornecedor, mesmo número, mesmo valor já registrado.
Repare que a IA não valida nada disso. Quem valida é código determinístico — SQL, Python ou um nó de regra em KNIME. A IA lê; a regra confere. Misturar as duas funções é o erro que transforma um bom projeto em passivo de auditoria.
5. Registro e fila de exceção
O que passa em todas as validações segue para o ERP. O que falha vai para uma fila com o documento original ao lado dos campos extraídos, para conferência em segundos — não para reprocessamento do zero.
Essa fila é o coração do processo. Ela precisa de dono e de acompanhamento: se a taxa de exceção sobe de forma silenciosa, alguém tem que perceber antes que o time volte a digitar tudo por desconfiança.
O que medir para saber se está funcionando
Três indicadores bastam nos primeiros meses:
- Taxa de passagem direta — percentual de documentos que chegam ao ERP sem toque humano. É o número que traduz o ganho real.
- Taxa de erro não detectado — campos errados que passaram pelas validações. Mede-se por amostragem periódica, e é o único indicador que justifica parar o processo.
- Tempo médio por exceção — se a conferência de uma exceção demora tanto quanto digitar o documento inteiro, a tela de conferência está mal desenhada.
Não persiga 100% de passagem direta. Documento ilegível, fornecedor com layout caótico e caso realmente ambíguo vão existir sempre — e forçar o modelo a decidir nesses casos é como você cria erro silencioso.
Onde essa automação encaixa no processo
O destino mais óbvio é contas a pagar e receber: o documento chega, vira título provisionado, entra no fluxo de aprovação com alçada humana preservada. Pagamento nunca deve ser disparado por extração automática sem aprovação.
Mas o mesmo fluxo serve a outras frentes. Em contabilidade, alimenta a provisão de despesas do fechamento com documentos que chegam depois do corte. Em fiscal, permite conferir retenções declaradas contra as calculadas antes do vencimento da obrigação. Em tesouraria, transforma contratos de dívida e aluguel em uma base consultável de vencimentos, índices de reajuste e cláusulas.
Tecnicamente, a montagem costuma combinar orquestração em n8n ou Airflow, tratamento e validação em Python ou KNIME, a API do modelo para a camada de leitura e o ERP — SAP, Protheus, NetSuite ou outro — como destino final.
Por onde começar
Escolha um tipo de documento, não todos. O melhor candidato tem volume alto, estrutura razoavelmente estável e uma fonte independente para validar — fatura de serviço com boleto anexo é quase sempre a melhor porta de entrada.
Rode em paralelo por um ciclo: o time continua digitando normalmente e o fluxo automático processa em silêncio. No fim do mês, compare campo a campo. Você descobre a taxa de erro real antes de depender dela, e o time ganha confiança com evidência em vez de promessa.
Na WIIP, começamos pelo diagnóstico do volume e da variação dos documentos antes de escolher modelo ou ferramenta — é isso que determina se o caso vale a pena. Se quiser avaliar o seu, veja a página de IA para Finanças ou fale com a gente.
Qual a diferença entre OCR e leitura de documentos com IA?
IA consegue ler nota fiscal de serviço de qualquer prefeitura?
Precisa de OCR se o PDF já é digital?
Como garantir que o valor extraído está correto?
Quanto custa processar documentos com IA?
A IA não descobre por que a margem caiu — mas escreve o comentário depois que os dados apontam onde…
→IA para finanças: onde a inteligência artificial realmente funciona no financeiroA IA entrega resultado consistente em três frentes do financeiro: ler documentos não estruturados, …