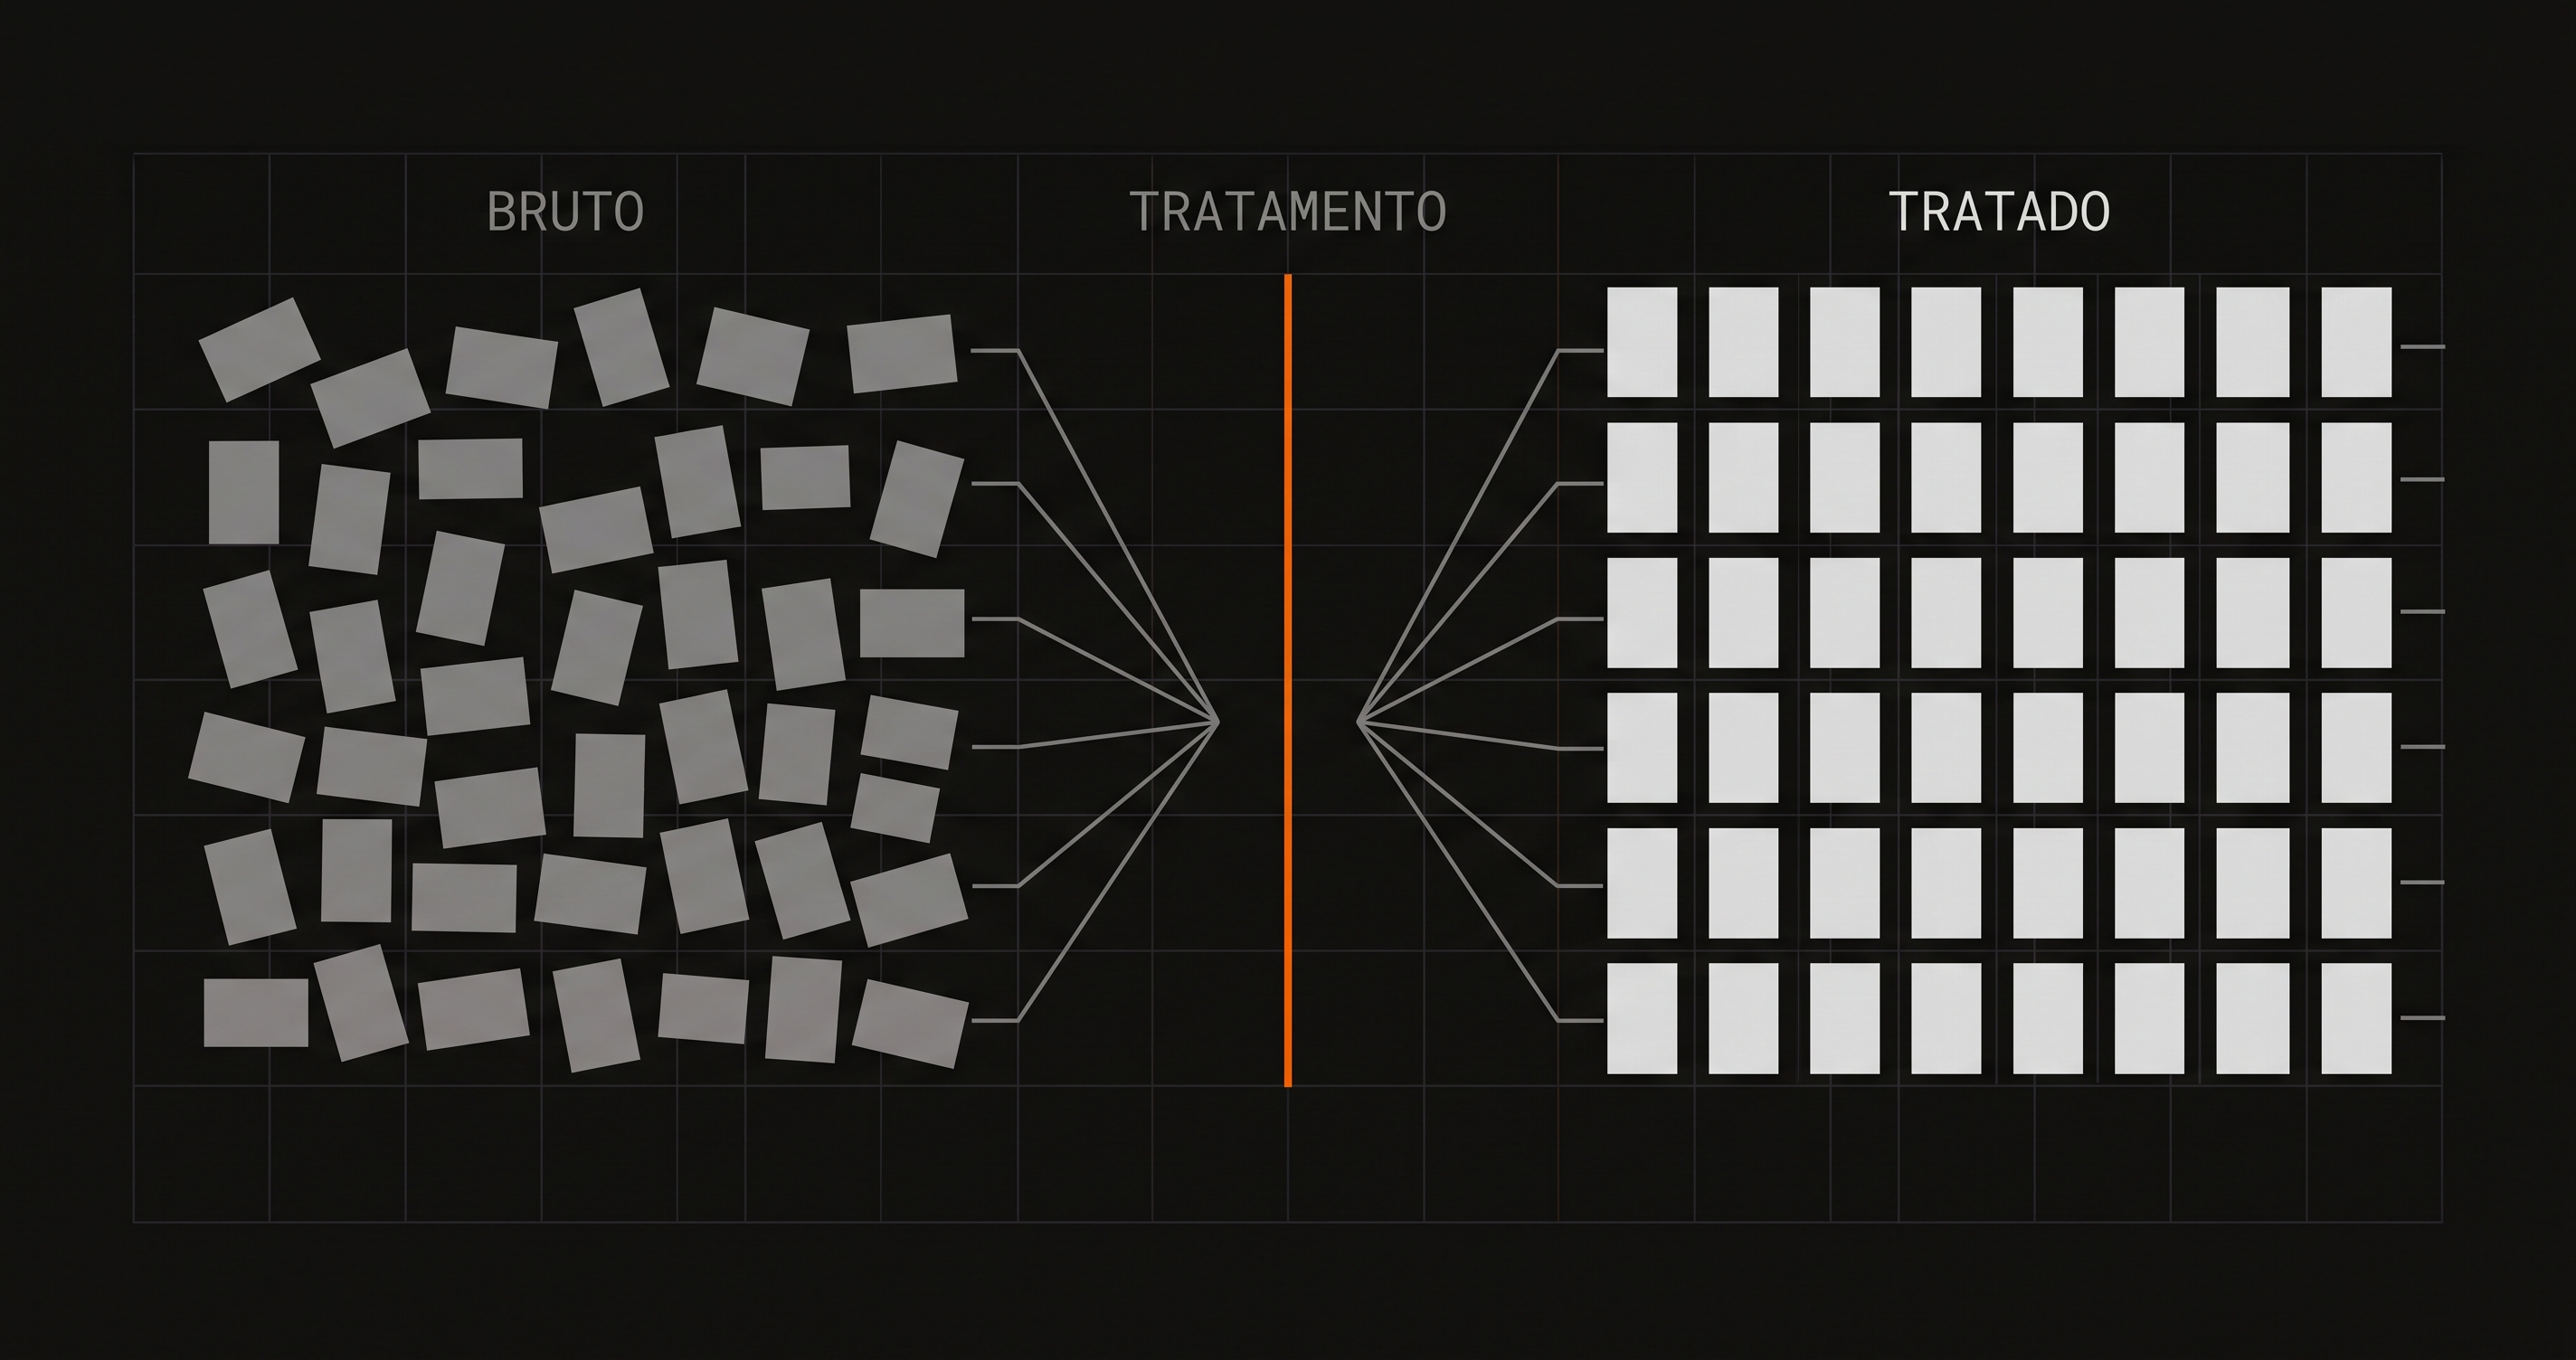
ETL financeiro é o que acontece entre o dado sair do ERP e entrar no relatório: normalizar formato, resolver cadastro divergente, eliminar duplicidade, aplicar a regra de negócio e validar antes de publicar. É a etapa que mais consome tempo em qualquer projeto de automação e a que menos aparece na apresentação. Quando ela não existe como etapa própria, o tratamento migra para dentro do relatório — e é assim que dois dashboards da mesma empresa passam a mostrar números diferentes.
O sintoma que denuncia a falta de ETL
Alguns sinais são inconfundíveis:
- Dois relatórios sobre o mesmo assunto não batem, e ninguém sabe qual está certo.
- O número muda dependendo de quem atualiza o arquivo.
- A mesma classificação de despesa é feita de novo, manualmente, em cada relatório.
- Quando alguém questiona um valor, a resposta exige refazer o caminho inteiro para descobrir onde ele se formou.
Todos esses sintomas têm a mesma causa: a regra de negócio está espalhada pelas pontas em vez de estar em um lugar só. Cada planilha e cada dashboard reimplementa a seu modo o que deveria ter sido decidido uma vez.
O que a etapa de tratamento precisa fazer
Normalizar
Dado financeiro brasileiro chega com uma variedade de formatos que surpreende quem não trabalha com ele: data em três padrões diferentes, valor com vírgula e com ponto, CNPJ com e sem máscara, número negativo representado por sinal, por parênteses ou por um campo separado de natureza.
Normalizar é reduzir tudo isso a uma representação única na entrada. Parece trivial e é responsável por uma boa parte dos erros que só aparecem semanas depois — tipicamente quando o mês vira e uma data ambígua como 03/04 muda de significado.
Resolver cadastro
O mesmo fornecedor aparece como "Transportes ABC Ltda", "ABC TRANSPORTES" e "Transp ABC". O mesmo cliente tem dois códigos no ERP. O centro de custo mudou de nome no meio do ano e o histórico ficou partido.
Esse é o trabalho mais chato e mais valioso do ETL. A solução costuma combinar chave forte quando existe — CNPJ normalizado —, tabela de correspondência mantida pelo time para os casos conhecidos, e fila de revisão para o que sobrar. Resolver cadastro uma vez, no tratamento, evita que cada relatório resolva à sua maneira.
Deduplicar
Reprocessamento, exportação sobreposta e arquivo baixado duas vezes produzem o mesmo registro repetido. Sem chave de deduplicação, o total infla e ninguém nota até alguém conferir contra o extrato.
A regra prática: toda carga precisa de uma chave que identifique unicamente o registro na origem, e o processo precisa ser idempotente — rodar duas vezes o mesmo dia tem que produzir o mesmo resultado.
Aplicar a regra de negócio
É aqui que mora a decisão: o que conta como receita recorrente, como a despesa é rateada entre centros de custo, o que entra na base de um indicador. Essas definições são da área financeira, não do relatório.
Colocá-las no tratamento tem uma consequência prática importante: quando a regra muda, muda em um lugar e todos os relatórios passam a refletir a nova versão. Quando elas vivem espalhadas, mudar a regra significa caçar todas as cópias.
Validar
Nenhuma carga deveria publicar sem passar por checagem automática. As que resolvem a maior parte dos problemas:
- Totais contra a origem. A soma do que foi carregado bate com a soma do relatório do ERP.
- Contagem de registros. Variação brusca em relação à média dos últimos dias é sinal de extração incompleta.
- Chaves órfãs. Lançamento apontando para fornecedor ou centro de custo que não existe na dimensão.
- Faixas de sanidade. Data fora do período esperado, valor com ordem de grandeza incompatível, campo obrigatório vazio.
E a regra que define a maturidade do processo: falha interrompe a carga. Publicar dado suspeito com um aviso no rodapé é como não ter validação nenhuma, porque ninguém lê o rodapé.
Python ou KNIME
Os dois resolvem. A escolha é menos sobre capacidade técnica e mais sobre quem vai manter o fluxo daqui a um ano.
KNIME
Fluxo visual, montado por nós encadeados. As vantagens aparecem no dia a dia da área financeira: o processo é legível para quem não programa, o analista consegue inspecionar o dado em qualquer ponto do fluxo, e alterações simples não exigem chamar alguém de TI.
Encaixa bem em tratamento estável, com lógica de transformação mais sequencial que condicional, e em times onde a manutenção precisa ficar dentro de finanças. O limite aparece quando a lógica cresce: fluxo com muitos nós e ramificações fica difícil de ler, e o controle de versão é mais pobre que o de código.
Python
Mais controle, reaproveitamento real de código, teste automatizado e versionamento decente. Lida melhor com lógica complexa, com volume grande e com regra que precisa ser reutilizada em vários processos.
O custo é de dependência: se ninguém na área lê o código, o fluxo vira caixa-preta na primeira ausência. Isso se resolve com documentação e com mais de uma pessoa envolvida — mas precisa ser decisão consciente, não descoberta depois.
O desenho misto
Na prática, muita operação acaba combinando: Python nas etapas de extração e nas regras mais elaboradas, KNIME nos fluxos que a área financeira precisa enxergar e ajustar. Não há elegância nisso, e funciona.
Onde guardar o resultado
Tratamento precisa desembocar em algum lugar estável. A pergunta "preciso de data warehouse?" costuma travar projetos que se resolveriam com muito menos.
Um PostgreSQL com as tabelas tratadas já entrega o essencial: uma fonte única, consultável por SQL, que o Power BI e as planilhas consomem sem refazer o tratamento. Estrutura maior — Databricks, camadas, modelagem dimensional completa — faz sentido quando o volume e o número de consumidores justificam, e é uma decisão que pode esperar.
O que não pode esperar é a separação: dado bruto preservado como chegou, dado tratado em outra camada. Quando o bruto é sobrescrito, reprocessar vira impossível e qualquer erro de regra é irreversível.
Um detalhe que evita retrabalho
Guarde, junto de cada registro tratado, de onde ele veio e quando foi carregado. Parece excesso de zelo até a primeira vez que alguém pergunta por que um número mudou entre ontem e hoje — e você consegue responder em minutos em vez de reconstruir o caminho.
Como isso se conecta ao resto
O tratamento fica entre a integração dos sistemas, que traz o dado, e o relatório, que o exibe. É a camada onde a regra financeira vive — e é o que permite que o forecast de caixa e o fechamento consumam a mesma base sem divergir.
Comece por um processo só: aquele em que o número já foi questionado alguma vez. Escreva as regras que hoje estão implícitas, implemente as validações e rode em paralelo. A discussão que esse exercício provoca dentro do time costuma ser mais valiosa que o próprio código.
Na WIIP, o tratamento é onde mais tempo de projeto é investido, justamente porque é onde o resultado se decide. Se quiser estruturar isso na sua operação, fale com a gente.
O que é ETL em finanças?
Python ou KNIME para tratamento de dados financeiros?
Preciso de data warehouse para automatizar relatórios financeiros?
Por que o relatório dá números diferentes dependendo de quem roda?
Como validar se o ETL está correto?
Toda área financeira tem aquela planilha que ninguém pode perder e só uma pessoa entende. Antes de …
→Integração de ERP com bancos e sistemas: arquivo, API ou acesso ao banco de dadosExistem três formas de tirar dado de um ERP e três de trocar dado com banco. A escolha entre elas d…